01 / 总览
先记住:GMM 反复做两件事
GMM 假设所有点是由若干个高斯分布混合生成的。这里有两个高斯分布,记作 G1 和 G2。每轮先问“每个点像谁”,再用新的归属概率重新画两个高斯。
1
E 步
根据当前的中心、协方差和权重,计算每个点属于每个高斯的概率。
2
M 步
把概率当作“软权重”,重新计算两个高斯的均值、协方差和混合权重。
3
判断收敛
如果参数或整体对数似然几乎不再变化,就停止。
02 / 数据与初始化
我们到底在处理哪个点?
选中的点:第 1 行
(66.4791, 59.9396)
这是一个二维向量。第一维是横坐标,第二维是纵坐标。GMM 只使用坐标,不使用标签。
“第 1 个点”不是特殊点,只是为了讲解方便。换成任意一个点,计算流程完全相同。
教学初始化
| G1 | G2 | |
|---|---|---|
| 均值 μ | (72, 58) | (35, 58) |
| 权重 π | 0.5 | 0.5 |
| 协方差 Σ | 100 I = [[100, 0], [0, 100]] | |
初始化只是起点。实际程序通常用多次随机初始化,避免停在较差的局部最优。
03 / E 步:对一个点打分
这个点更像 G1,还是更像 G2?
二维高斯密度的公式是:
N(x | μ, Σ) = 1 / (2π |Σ|¹ᐟ²) · exp( −½ (x−μ)ᵀ Σ⁻¹ (x−μ) )
它包含三个直觉:点离中心越近,密度越大;椭圆面积越小,密度越集中;协方差决定椭圆的方向和形状。
3.1 代入 G1
x − μ₁ = (66.4791−72, 59.9396−58)
= (−5.5209, 1.9396)
Σ₁⁻¹ = [[0.01, 0], [0, 0.01]]
(x−μ₁)ᵀΣ₁⁻¹(x−μ₁) = 0.342425
N(x|G1) = 0.00134111
π₁ N(x|G1) = 0.5 × 0.00134111
= 0.000670553
3.2 代入 G2
x − μ₂ = (31.4791, 1.9396)
(x−μ₂)ᵀΣ₂⁻¹(x−μ₂) = 9.946942
N(x|G2) = 0.0000110121
π₂ N(x|G2) = 0.000005506
3.3 归一化:得到“责任度”
上面两个数还不是概率,因为它们没有加起来等于 1。归一化公式为:
γ₁ = P(G1|x) = 0.000670553 / (0.000670553 + 0.000005506)
= 0.991856
γ₂ = P(G2|x) = 0.000005506 / (0.000670553 + 0.000005506)
= 0.008144
结论 第 1 个点有 99.1856% 的概率属于 G1,有 0.8144% 的概率属于 G2。GMM 现在仍然保留不确定性。
04 / M 步:让参数适应数据
把“概率”当作软权重
对所有 79 个点都完成 E 步后,每个点都有两个责任度 γ。M 步使用这些责任度重新估计参数。
有效样本数
Nₖ = Σᵢ γᵢₖ
第 0 轮得到:
N₁ = 52.8531
N₂ = 26.1469
更新混合权重
πₖ = Nₖ / N
π₁ = 52.8531 / 79 = 0.669027
π₂ = 26.1469 / 79 = 0.330973
虽然数据有 79 个点,但 N₁、N₂ 是软计数,所以仍满足 N₁+N₂=79。
更新均值
μₖ = (Σᵢ γᵢₖ xᵢ) / Nₖ
μ₁ = (69.5896, 58.1700)
μ₂ = (28.7309, 57.8493)
责任度较大的点,对均值的影响更大;责任度接近 0 的点,影响很小。
更新协方差
Σₖ = [Σᵢ γᵢₖ (xᵢ−μₖ)(xᵢ−μₖ)ᵀ] / Nₖ
协方差不是只看横、纵方向的方差,还包含非对角元素,因而可以形成倾斜椭圆。
05 / 重复
参数如何逐渐稳定?
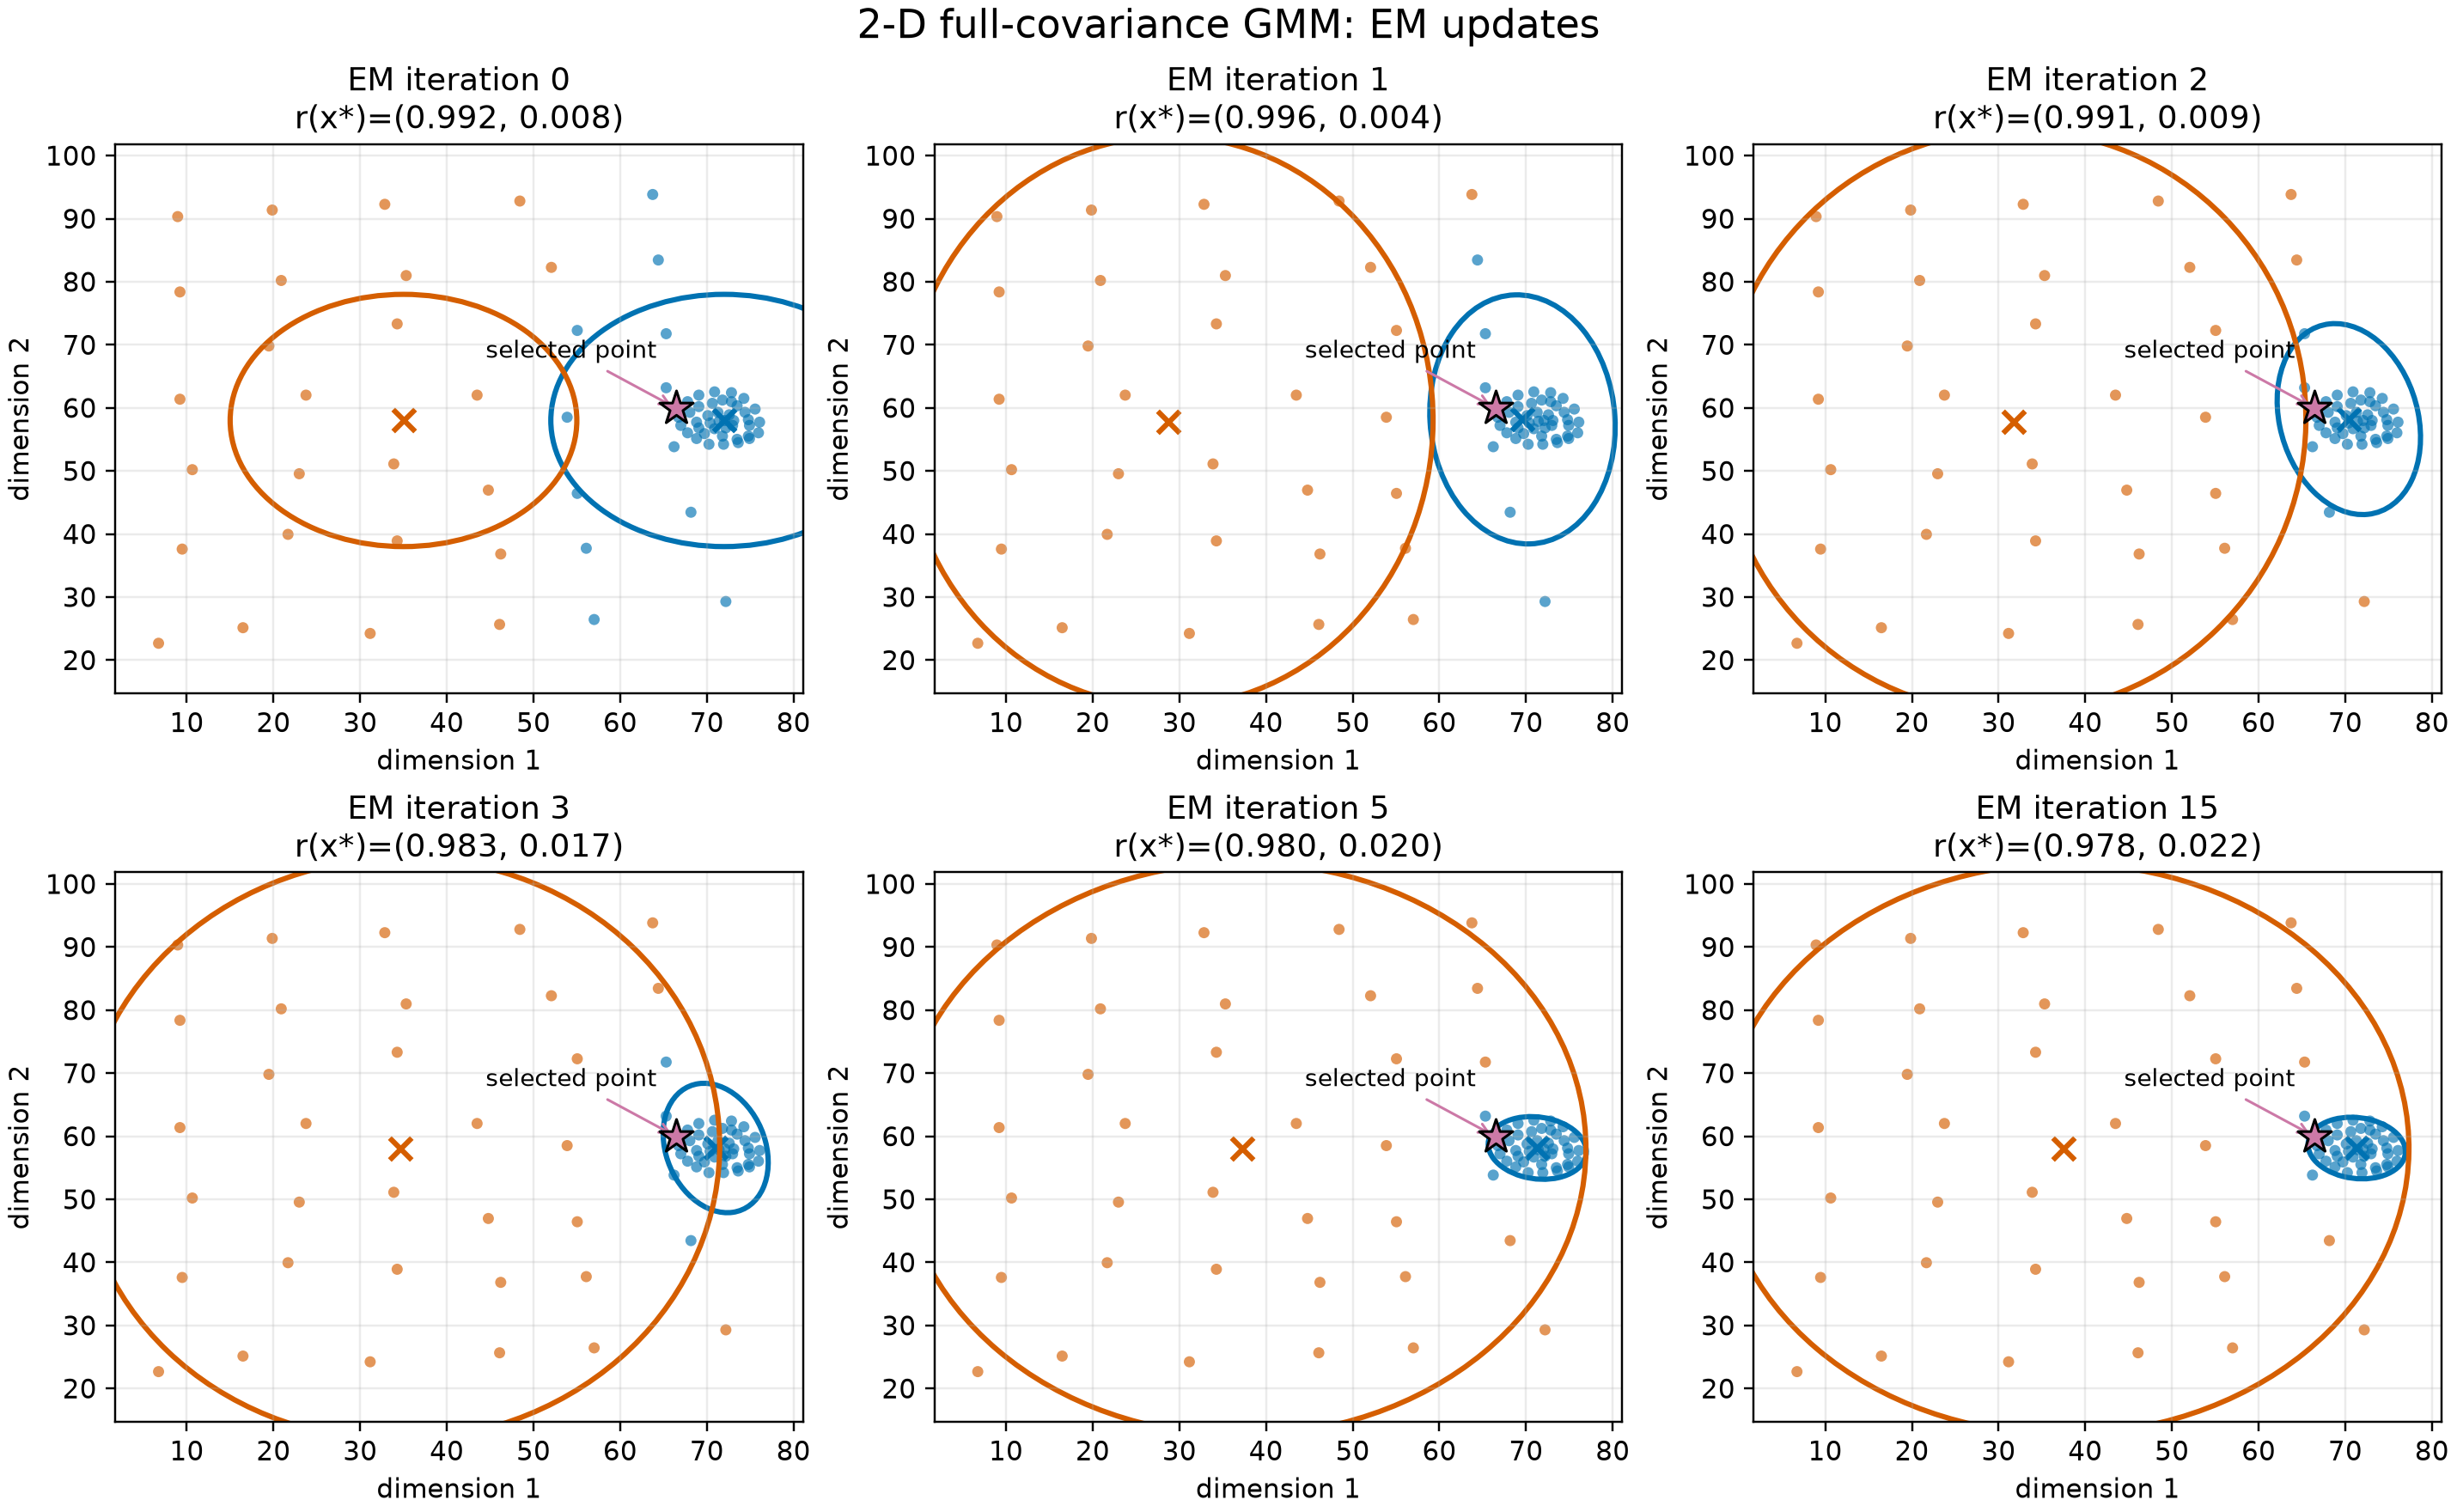
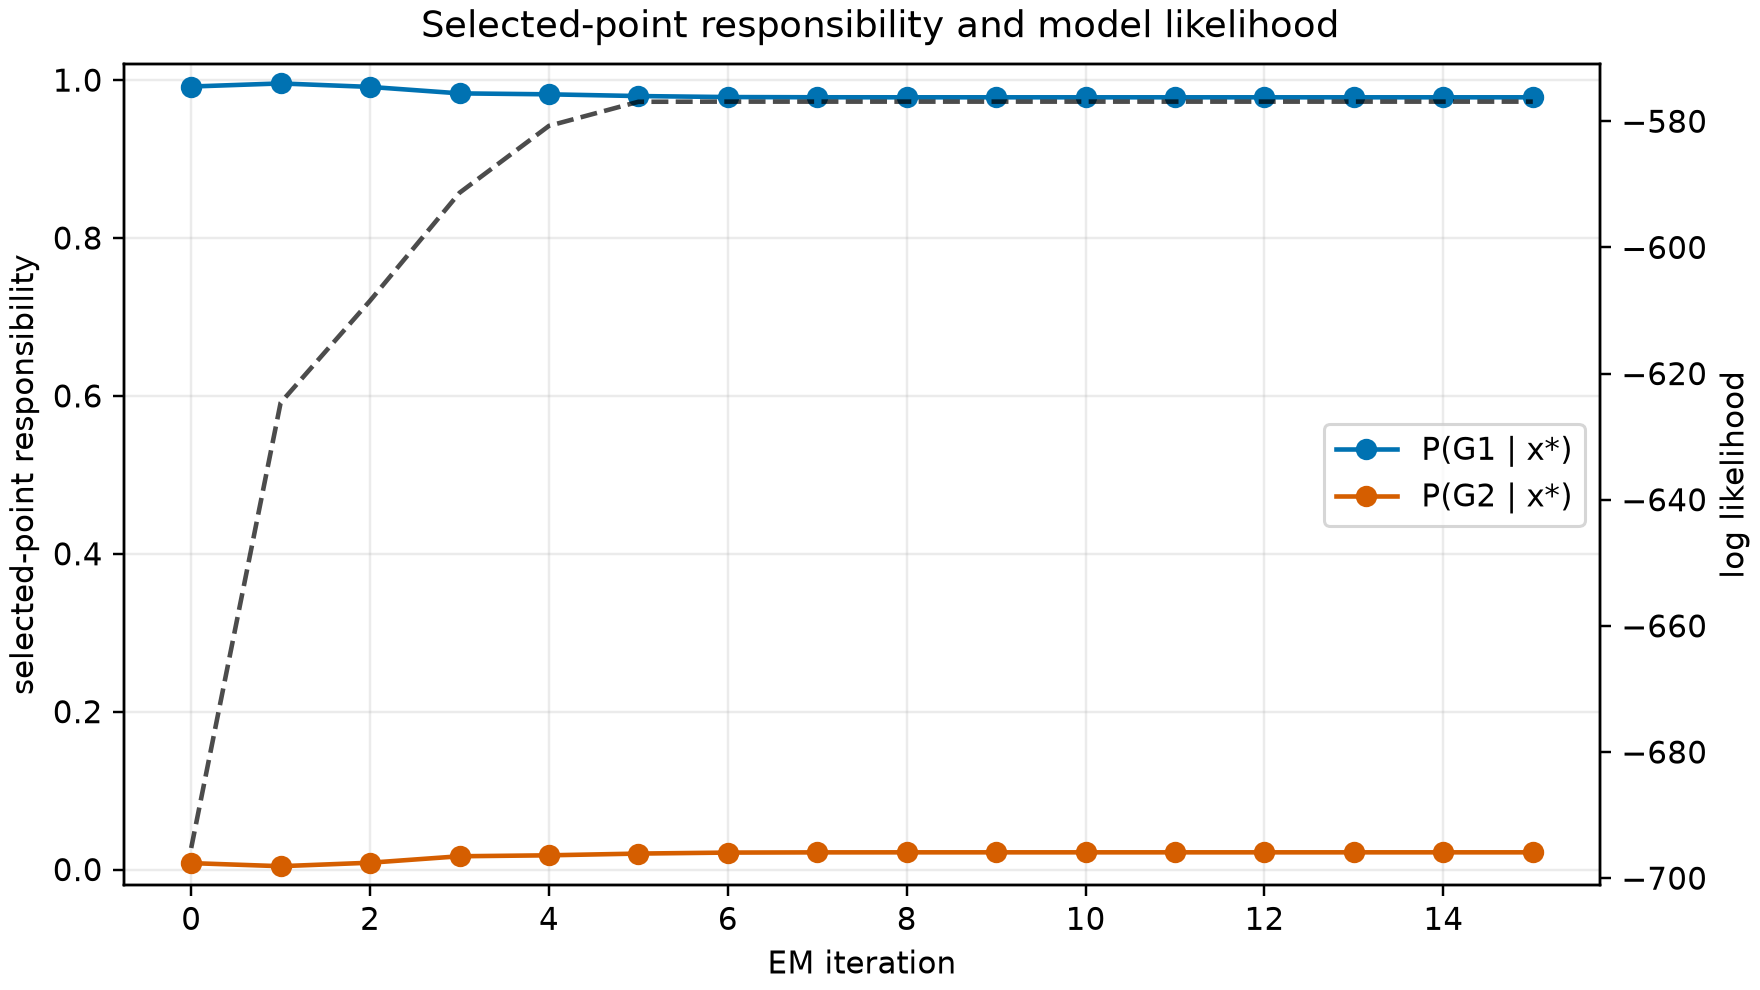
每一轮都再次执行 E 步和 M 步。下表展示同一个点的概率、两个高斯的中心和有效样本数。
选一个 EM 轮次查看
下拉菜单中的数值均来自原始数据实际计算。
P(G1 | x*)—
P(G2 | x*)—
G1 均值—中心位置
G2 均值—中心位置
| 轮次 | P(G1|x*) | P(G2|x*) | π₁ | π₂ | log likelihood |
|---|---|---|---|---|---|
| 0 | 0.991856 | 0.008144 | 0.500000 | 0.500000 | −695.2188 |
| 1 | 0.995775 | 0.004225 | 0.669027 | 0.330973 | −624.6230 |
| 2 | 0.991365 | 0.008635 | 0.629374 | 0.370626 | −608.4500 |
| 3 | 0.983187 | 0.016813 | 0.589293 | 0.410707 | −591.3420 |
| 5 | 0.979788 | 0.020212 | 0.552099 | 0.447901 | −576.9119 |
| 10 | 0.978202 | 0.021798 | 0.548398 | 0.451603 | −576.8894 |
| 15 | 0.978202 | 0.021798 | 0.548397 | 0.451603 | −576.8894 |
06 / 最终结果
这一个点最后被分到哪里?
最终后验概率
G1:97.8202%
G2:2.1798%
因此这个点被分到 G1。注意:G1/G2 是算法内部编号,不一定天然等于 ground truth 的类别 1/2。
收敛后的参数
| G1 | G2 | |
|---|---|---|
| 权重 π | 0.548397 | 0.451603 |
| 均值 μ | (71.3250, 58.1247) | (37.5375, 57.9900) |
| 协方差 Σ | [[7.8798, −0.7758], [−0.7758, 5.9692]] | [[396.2152, 1.3717], [1.3717, 512.1800]] |
一句话总结:GMM 不是先给每个点贴死标签,而是先给出“属于每个高斯的概率”;M 步再用这些概率更新两个高斯,循环往复直到稳定。